Основы
Как работает поисковая система: как поисковик находит сайт
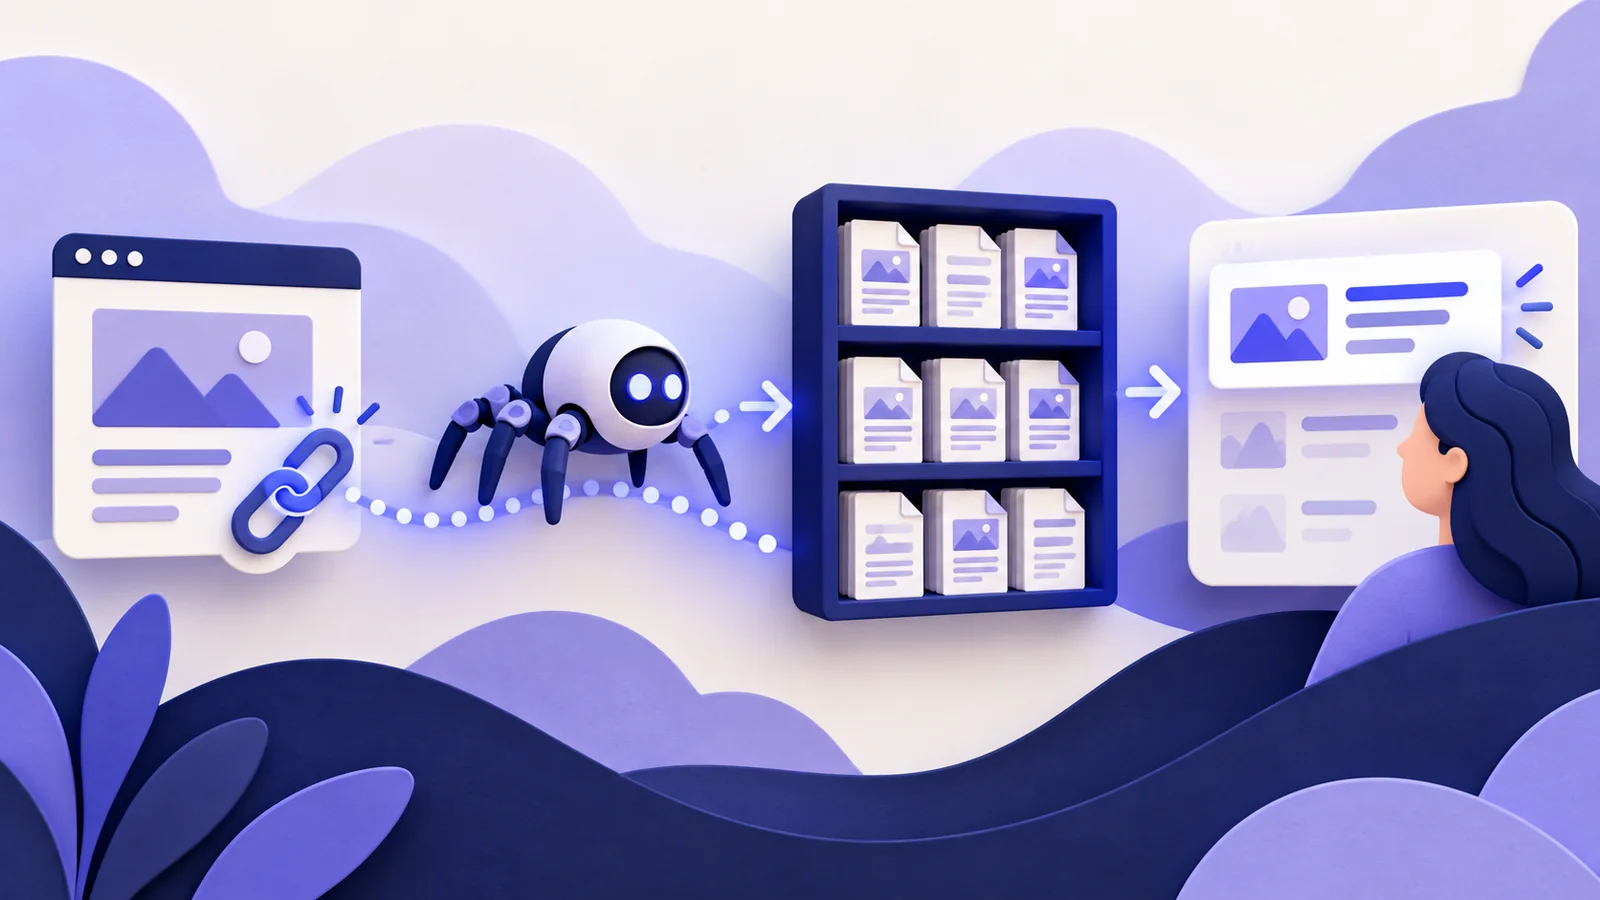
Поисковая система работает в три шага: робот находит и загружает страницы, поисковик сохраняет их в свою базу, а в момент запроса выбирает из базы лучшие ответы. Если страница выпала на любом шаге, в поиске ее не будет, как бы хорошо она ни была написана.
Как работает поисковая система простыми словами
Поисковик не ищет по интернету в момент вашего запроса — это заняло бы часы. Он заранее обходит сайты, сохраняет страницы в свою базу и за доли секунды ищет уже в ней.
Представьте библиотеку. Сотрудники постоянно привозят новые книги (сканирование), библиотекарь заносит их в каталог (индексация), а когда читатель спрашивает книгу, выбирает самые подходящие (ранжирование). Google описывает свой поиск ровно этими тремя этапами, у Яндекса они устроены так же.
Сканирование: как робот находит страницы
Робот, или краулер, — программа, которая открывает страницы, как браузер, только без человека. Новые адреса он узнает из ссылок на уже известных страницах, из карты сайта (sitemap — файла со списком адресов) и из панелей для владельцев: Яндекс Вебмастера и Google Search Console.
Перед обходом робот читает файл robots.txt — правила, какие разделы сайта ему можно открывать. Страницу, закрытую в robots.txt, робот не загрузит и не прочитает ее текст.
Пример. Интернет-магазин example.ru добавил новый раздел «Садовая мебель», но не поставил на него ни одной ссылки из меню и не добавил его в sitemap. Роботу неоткуда узнать об этом адресе — раздел может долго не появляться в поиске.
Индексация: что поисковик сохраняет
Индексация — разбор загруженной страницы и сохранение ее в базе поисковика, индексе. Поисковик читает текст, заголовки, картинки, ссылки и определяет, о чем страница.
Не каждая загруженная страница попадает в индекс. Google называет минимальные условия: робот может открыть страницу, сервер отвечает кодом 200 (страница работает), и на ней есть полезное содержимое. Страницы с ошибками 404 и 500, с запретом noindex (строкой в коде «не добавлять в поиск») и почти одинаковые копии других страниц обычно в индекс не идут.
Сайты на JavaScript — отдельный случай: текст появляется только после выполнения скриптов. Google выполняет их, Яндекс решает сам, нужно ли это делать. Надежнее, когда основной текст есть в коде страницы сразу.
- Страница закрыта в robots.txt — робот ее не загрузит
- Отвечает 404 или 500 — в индекс не попадет
- Есть noindex — поисковик уберет ее из поиска
- Копия другой страницы — в поиске останется одна версия
Ранжирование: как поисковик решает, что показать
Когда человек вводит запрос, поисковик выбирает из индекса подходящие страницы и выстраивает их по порядку. Учитываются сотни сигналов, и полного списка ни Яндекс, ни Google не раскрывают.
Главное они называют открыто. Яндекс в справке выделяет соответствие страницы задаче пользователя, экспертность, полезность, оригинальность и содержательность. Google говорит о смысле запроса, соответствии страницы, ее качестве, удобстве и контексте: местоположении, языке, устройстве.
Поэтому один запрос дает разные результаты разным людям. «Доставка пиццы» в Москве и в Казани покажет разные сайты, а товар без доставки в ваш регион проиграет магазину, который туда доставляет.
Что это значит для владельца сайта
Каждому шагу соответствует своя работа. Нет сканирования — проверяйте robots.txt, ссылки и sitemap. Нет индексации — коды ответа, noindex и дубли. Страница в индексе, но низко — работайте над содержимым и тем, насколько она полезнее соседних.
Начинайте с первых двух шагов: их проще проверить и быстрее исправить, а без них третий шаг не наступит.
Как проверить результат
Узнать, на каком шаге застряла страница, помогают панели поисковиков. В Яндекс Вебмастере раздел «Индексирование» показывает, какие страницы робот обошел и какие исключил из поиска и почему. В Google Search Console то же делает инструмент проверки URL.
Чтобы увидеть сайт глазами робота целиком, запустите проверку в SEO title: она обходит страницы как YandexBot или Googlebot и показывает закрытые и недоступные адреса. В справочнике ошибок это, например, «Важные страницы недоступны или закрыты от индексации» (IDX-09) и «Проблемы robots.txt» (IDX-01).
Первоисточники
FAQ
Частые вопросы
Что происходит раньше: обход или индексация?
Сначала поисковик обнаруживает адрес и пытается получить страницу. После этого он решает, сохранять ли её содержание в поисковой базе.
Может ли робот обойти страницу, но не добавить её в поиск?
Да. Успешный обход не означает автоматического включения: поисковик отдельно оценивает доступные данные и полезность страницы.
Почему проиндексированная страница не видна по любому запросу?
Индексация и ранжирование — разные этапы. Для конкретного запроса система выбирает страницы, которые считает наиболее подходящими.
Проверьте себя
Вопрос 1 из 2. Результат увидите только вы.
Обсуждение
На каком этапе — обнаружение, обход, индексация или показ — у вас возник вопрос?
Войдите, чтобы оставить комментарий. Читать обсуждение могут все. Комментарии проходят автоматическую и редакционную проверку.